Búsqueda Híbrida: La pieza que falta para que tu RAG no alucine
Descubre por qué la búsqueda vectorial no es suficiente para tu RAG y cómo implementar búsqueda híbrida para mejorar la precisión de tu IA empresarial.
El 80% de los proyectos de Retrieval-Augmented Generation (RAG) que fracasan en producción no es por culpa del modelo de lenguaje, sino por una recuperación de datos mediocre. Muchas empresas en Medellín y el mundo se lanzaron a indexar sus PDFs en una base de datos vectorial creyendo que la "similitud semántica" era la bala de plata. Meses después, se encuentran con que su chatbot no puede encontrar un número de factura específico o confunde términos técnicos internos que solo varían por una sigla. La realidad es cruda: la búsqueda vectorial es excelente para conceptos, pero terrible para la precisión exacta.
El problema con la fe ciega en los vectores
Las bases de datos vectoriales como Pinecone, Weaviate o Milvus transforman texto en coordenadas matemáticas. Esto permite que el sistema entienda que "perro" es similar a "canino". Sin embargo, esta misma magia matemática hace que el sistema sea "miope" ante términos específicos. Si un usuario busca el código de error ERR-9942, la búsqueda vectorial podría devolver ERR-9943 porque están cerca en el espacio latente, aunque para el negocio la diferencia sea abismal.
La búsqueda semántica tradicional suele fallar en:
- Nombres propios y acrónimos: Términos industriales específicos que no están en el dataset de entrenamiento del embedding.
- Consultas cortas: Cuando el usuario solo escribe una palabra clave.
- Datos estructurados dentro de texto: Como números de serie, fechas exactas o IDs de producto.
¿Qué es la Búsqueda Híbrida y por qué la necesitas?
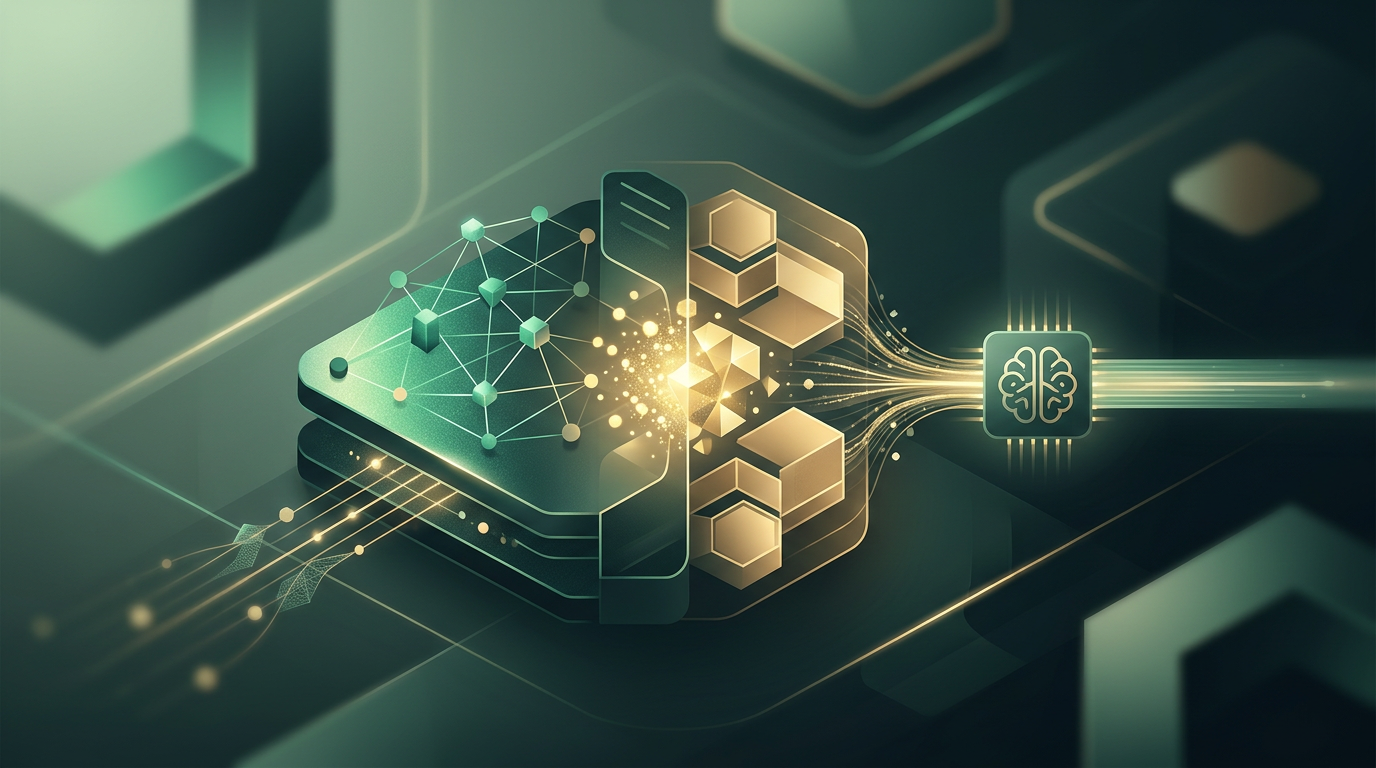
La búsqueda híbrida combina lo mejor de dos mundos: la búsqueda por palabras clave (BM25/TF-IDF) y la búsqueda vectorial (Dense Retrieval). Es, esencialmente, darle a tu IA tanto un diccionario como una enciclopedia de conceptos. Mientras que el vector captura la intención, el índice invertido captura la literalidad.
"La búsqueda híbrida no es solo una suma de partes; es un sistema de pesos donde el contexto del negocio decide qué importa más: el concepto o el dato exacto."
El rol del Reranking
Después de obtener resultados de ambos métodos, entra en juego el Cross-Encoder o Reranker. Este componente analiza el top 20 de resultados combinados y decide, con un costo computacional mayor pero mayor precisión, cuál es realmente el más relevante para la pregunta del usuario antes de pasar la información al LLM.
Arquitectura de una solución robusta
Para implementar esto con éxito, no basta con prender un interruptor. Requiere una orquestación clara de datos:
- Ingesta: El contenido se divide en chunks y se envía a dos motores. Uno genera embeddings y el otro crea un índice de términos.
- Recuperación: Ante una consulta, se ejecutan dos búsquedas en paralelo.
- Fusión: Se utiliza algoritmos como Reciprocal Rank Fusion (RRF) para normalizar los puntajes de ambos métodos.
- Generación: Solo los fragmentos con mayor puntaje llegan a la ventana de contexto del LLM.
# Ejemplo conceptual de RRF en Python
def rrf(vector_results, keyword_results, k=60):
    scores = {}
    for rank, doc_id in enumerate(vector_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank)
    for rank, doc_id in enumerate(keyword_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank)
    return sorted(scores.items(), key=lambda x: x[1], reverse=True)
Cuándo priorizar cada método
No todos los casos de uso requieren un balance 50/50. En un sistema de soporte técnico para una empresa de manufactura en Antioquia, las referencias de piezas deben tener un peso mayor en la búsqueda por palabras clave. En cambio, en una herramienta de análisis de sentimientos de clientes, el peso debe ir hacia el vector.
Herramientas recomendadas en 2025
- Elasticsearch/OpenSearch: Los reyes de la búsqueda textual que ahora manejan vectores de forma nativa.
- Weaviate: Una base de datos vectorial que integra búsqueda híbrida y reranking de manera muy fluida.
- LangChain/LlamaIndex: Para la orquestación del flujo entre la base de datos y el modelo (GPT-4o, Claude 3.5).
Cómo lo abordamos en Julsmind SAS
En Julsmind SAS, entendemos que la IA no es un juguete, es una herramienta de productividad. No nos limitamos a conectar una base de datos vectorial a un LLM. Diseñamos pipelines de datos que incluyen limpieza semántica, estrategias de chunking personalizadas y, crucialmente, motores de búsqueda híbrida optimizados para el lenguaje técnico de tu industria. Ya sea que estés en el sector financiero, logístico o de servicios, nos aseguramos de que tu RAG responda con hechos, no con alucinaciones creativas.
¿Tu sistema actual de IA está entregando respuestas vagas o incorrectas? El problema suele estar en cómo recuperas la información. Hablemos sobre cómo optimizar tu arquitectura de datos para que tu inversión en IA realmente mueva la aguja de tu negocio. Escríbenos en nuestra página de contacto y elevemos el nivel de tu inteligencia corporativa.